記事ごとのOGP画像を自動生成する:文字をパスにして30枚作った
XやSlackにこのブログのリンクを貼ると、タイトルの入った紙白の画像が出ます。あの画像は記事ごとに用意していますが、手で作ったものは1枚もありません。記事のMarkdownからタイトルを読み、フォントの輪郭をパスに変換してSVGを組み立て、PNGに書き出す。それを全記事ぶん一気に走らせるスクリプトを、サイト公開の前日に書きました。この記事の画像を含めて30枚。作る途中で決めた設計と、日本語ならではの折り返しの問題、そして末尾の一文字だけが化ける現象の正体を、実物と一緒に残しておきます。
記事タイトルからOGP画像を作る仕組みは、文字をパスにしてSVGを組みPNGにする、200行ほどのスクリプトで足りました。
何を作ったか
まず実物です。先日の記事「予約投稿が出なかった朝」のOGP画像がこれで、いま読んでいる記事の画像も同じスクリプトから出ています。
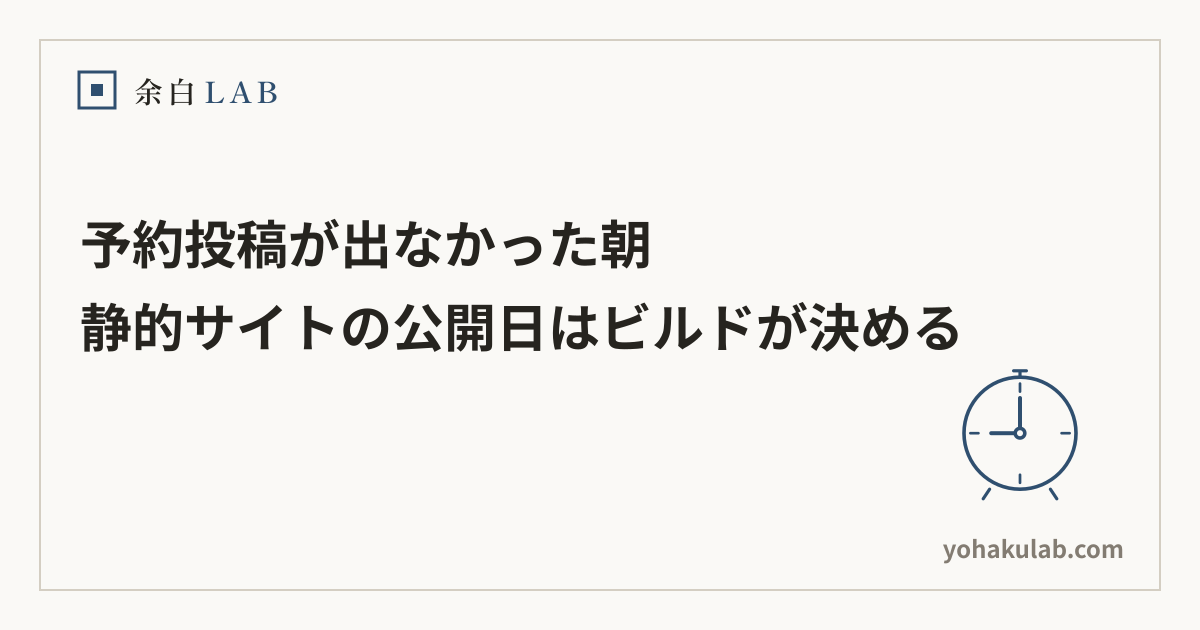
OGPは、リンクを貼ったときに表示されるタイトルや画像をページ側で指定するための仕様で、画像は og:image というメタタグで指定します※1。寸法は1200×630ピクセル。Facebookの開発者向けドキュメントが、高解像度の端末で最適に表示するための下限としている数字です※2。
画像の要素は5つで、上から順に、ロゴ(左上)、タイトル(最大3行)、記事ごとの線画(右下)、ドメイン名(右下)、それらを囲む細い罫線の枠。色は本文のサイトと同じで、紙白の背景に墨色の文字、藍色のロゴと線画です。サイトの見た目をそのまま画像にしただけなので、凝ったところはありません。凝ったのは、これを人手なしで安定して出すほうです。
設計で決めた3つ
1. フォントを実行環境に頼らない
日本語の文字を画像に描くとき、いちばん壊れやすいのはフォントです。手元のパソコンでは出た文字が、別の環境では豆腐(□)になる。それを避けるため、文字を「文字」のまま描かず、輪郭の「パス」に変換してからSVGに埋めることにしました。
使ったのはopentype.jsという、JavaScriptでOpenTypeフォントを読み書きするライブラリです※3。フォントファイルを読み込み、font.getPath(文字列, x, y, サイズ) を呼ぶと、その文字列の輪郭が座標の列で返ってきます。これをSVGの <path d="..."> にすれば、あとはフォントが無い環境でも同じ形が出る。
フォント自体はGoogle FontsのNoto Sans JP※4のTTFを、初回だけ取りに行って scripts/.fonts/ にキャッシュしています。サイト本文と同じ書体を使いたかったのと、太字(700)が1ファイルで済むのが理由です。
SVGからPNGへの変換はsharpに任せました※5。Node.jsの画像処理ライブラリで、SVGの文字列を渡すとそのままPNGに描いてくれます。
const svg = buildSvg(font, logo, title, illust);   // SVG文字列を組み立てる
await sharp(Buffer.from(svg)).png().toFile(`public/ogp/${slug}.png`);
2. 線画は別ファイルにして、記事側から名前で呼ぶ
右下の小さな絵は、記事ごとに illust: clock のようにfrontmatterで指定しています。実体は scripts/illustrations/clock.svg で、200×200の座標系で線だけを描いた小さなSVGです。スクリプトはその中身(パス群)を取り出して、OGPの右下に縮小して置きます。
<svg viewBox="0 0 200 200" fill="none" stroke="#2f4f6f" stroke-width="4.5">
  <circle cx="100" cy="104" r="70" />
  <path d="M100 104 V60" stroke-width="5" />
  <path d="M100 104 H64" stroke-width="5" />
</svg>線画を別ファイルにしたのは、記事を書く作業と絵を描く作業を切り離したかったからです。新しい記事に合う絵が無ければ、illust: を書かなければ絵なしで生成されます。いまは30本の記事に対して線画は27種類。時計・荷札・額縁のように、記事1本のためだけに描いたものも多いですが、1個あたり10行前後のSVGなので負担にはなっていません。
3. ビルドには組み込まず、生成したPNGをコミットする
スクリプトは npm run ogp で手で走らせ、できたPNGを public/ogp/ に置いてGitにコミットしています。サイトのビルドには入れていません。
組み込まなかった理由は、生成した画像を目で見てからpushしたかったからです。日本語の折り返しは、あとで書くとおり完全には自動化できず、たまに手で改行位置を直します。ビルドのたびに全部作り直すより、記事を足したときに1回走らせて確認するほうが、このブログの規模には合っていました。画像が無い記事は、サイト共通のOGP画像に自動で切り替わるようにしてあります。
日本語の折り返しには禁則が要る
タイトルは最大3行に折り返します。英語なら空白で切ればよいのですが、日本語には空白がありません。文字の幅を足していって枠を超えたら折る、という単純な方法だと、行の頭に「。」や「ー」が来たり、行の末尾に「「」が残ったりします。
これは日本語組版の世界で「行頭禁則」「行末禁則」と呼ばれている決まりで、W3Cの「日本語組版処理の要件」にも項目があります※6。スクリプトでは、行頭に置いてはいけない文字と、行末に置いてはいけない文字を、それぞれ文字列で持っておき、折り返し位置がそれに当たったら1文字ずらしています。
// 行頭に置いてはいけない文字(終わり括弧・句読点・小書き仮名・長音など)
const NO_LINE_START = 'ぁぃぅぇぉっゃゅょゎァィゥェォッャュョヮー、。,.:;!?」』)〕】》〉”’%';
// 行末に置いてはいけない文字(始め括弧)
const NO_LINE_END = '「『(〔【《〈“‘';
それでも「意味の途中で折れる」問題は残ります。「静的サイトの公開日は」で折れてほしいのに「静的サイトの公開日はビ」で折れる、といったことです。これは機械には判断がつかないので、frontmatterに ogpTitle という項目を用意し、タイトルの中に | を書いた位置で改行する仕組みにしました。1本目の記事なら 予約投稿が出なかった朝|静的サイトの公開日はビルドが決める と書いています。全自動をあきらめて、改行位置だけ人が指定する。ここが、この仕組みでいちばん人手が残っている場所です。
末尾の一文字だけが化けた
公開の翌日、8月8日の午前中、いくつかの画像でタイトルの最後の文字が欠けたり、壊れた形になっているのに気づきました。全部ではなく、特定のタイトルだけ。フォントの問題かと思って調べたら、違いました。
opentype.jsには、パスをSVGの d 属性の文字列に変換する toPathData() という便利な関数があります。最初はそれを使っていたのですが、一部のグリフ(文字の形)で、この関数が座標に NaN(数値でない値)を含んだ文字列を返していました。SVGの側は d 属性を先頭から読んでいき、解釈できないところで止まります。つまり、NaN が混ざった文字から後ろが描かれない。最後の文字だけが化けて見えたのは、たまたまその位置で止まっていたからでした。
対策は、toPathData() を使うのをやめて、座標の列から自分で d 属性を組み立てることです。座標が数値でなければ例外を投げて止まるようにして、黙って壊れた画像が出ないようにしました。
function pathToD(path) {
  const n = (v) => {
    if (!Number.isFinite(v)) throw new Error('座標が数値ではありません');
    return Math.round(v * 100) / 100;
  };
  return path.commands.map((c) => {
    switch (c.type) {
      case 'M': return `M${n(c.x)} ${n(c.y)}`;
      case 'L': return `L${n(c.x)} ${n(c.y)}`;
      case 'Q': return `Q${n(c.x1)} ${n(c.y1)} ${n(c.x)} ${n(c.y)}`;
      case 'C': return `C${n(c.x1)} ${n(c.y1)} ${n(c.x2)} ${n(c.y2)} ${n(c.x)} ${n(c.y)}`;
      case 'Z': return 'Z';
      default:  return '';
    }
  }).join('');
}
なぜ特定のグリフだけで NaN が出るのかは、突き止めていません。使っているフォントとopentype.jsの版の組み合わせで起きる何かだろう、というところで止めています。自前で組み立てる側に切り替えてからは、30枚とも欠けなく出ているので、原因の深掘りより先に運用に戻りました。
3日で3回変わった
このスクリプトの履歴を並べると、公開前後の3日間でこうなっています。
| 日時 | 変更 |
|---|---|
| 8月7日 11:42 | 初版。タイトルとカテゴリー名を入れた画像を全記事ぶん生成 |
| 8月8日 11:02 | 記事ごとの線画を追加。カテゴリー名は外す |
| 8月8日 11:57 | 末尾の文字化けを修正。長いタイトルの省略をやめ、ogpTitle で改行位置を指定する方式に |
| 8月18日 | 30枚。以後は記事を足すたびに1回走らせるだけ |
1枚あたり45〜55KBのPNGが30枚。ファイルとしては1.5MB程度で、Gitに入れる負担も気になりません。記事を書く側の作業は、illust: に絵の名前を書き、必要なら ogpTitle に | を入れ、npm run ogp を叩く。この3手順で、SNSに貼ったときの見た目まで記事と一緒に決まるようになりました。
参考文献・出典
※1 : 「The Open Graph protocol」 |ogp.me https://ogp.me/
※2 : 「リンクシェアの中の画像指定」 |Meta for Developers https://developers.facebook.com/docs/sharing/webmasters/images/
※3 : 「GitHub - opentypejs/opentype.js: Read and write OpenType fonts using JavaScript.」 |GitHub https://github.com/opentypejs/opentype.js
※4 : 「Noto Sans Japanese - Google Fonts」 |Google Fonts https://fonts.google.com/noto/specimen/Noto+Sans+JP
※5 : 「High performance Node.js image processing | sharp」 |sharp https://sharp.pixelplumbing.com/
※6 : 「Requirements for Japanese Text Layout 日本語組版処理の要件(日本語版)」 |W3C https://www.w3.org/TR/jlreq/
よくある質問
OGP画像とは何ですか?
X(Twitter)やFacebook、Slackなどでリンクを貼ったときに、タイトルと一緒に表示される画像です。ページのHTMLに og:image というメタタグで画像のURLを書いておくと、各サービスがそれを取りに来て表示します。仕様はThe Open Graph protocolとして公開されています。
OGP画像の推奨サイズは?
Facebookの開発者向けドキュメントでは、高解像度の端末できれいに表示するために1200x630ピクセル以上を推奨しています。このブログでもその寸法で作っています。
日本語のOGP画像を自動生成するとき、フォントはどうしていますか?
このブログでは、Google FontsからNoto Sans JPのTTFファイルを取得して手元にキャッシュし、opentype.jsで文字の輪郭をSVGのパスに変換しています。文字をパスにしてしまえば、画像を作る環境にそのフォントが入っているかどうかに左右されません。